本機優先讓敏感提示與供應商金鑰留在電腦上,同時維持快速可靠的工作流程。
LLM API 用戶端與模型評測 · macOS
在 Mac 上測試 LLM API,比較不同模型。
在同一個本機優先工作區編寫真實的對話請求、跨模型執行並為結果評分。不需帳號或託管代理伺服器,你的金鑰只留在 Mac。
免費、開放原始碼,並經過 Apple 簽署與公證。想要自動更新? 在 Mac App Store 以 US$0.99 購買。
macOS 12 Monterey 或更新版本Apple 晶片與 Intel英文與繁體中文介面不需建立帳號
助理GPT-5.4 mini
測試 LLM API、比較模型,並以證據做出選擇。
OpenAIAnthropicGoogle GeminiOpenRouterOpenAI 相容端點Anthropic 相容端點
內建模型評測
不用再把不同模型的輸出分散在多個分頁。
從實際請求開始,加入想測試的模型並一起執行。Roshi 會固定提示與參數,並對齊輸出、延遲、Token 與成本,讓你以證據選擇模型。
- 01並行執行模型每個回應抵達時即時串流顯示。
- 02並排比較一起檢視輸出、延遲與 Token 用量。
- 03評估重要指標手動評分,或使用自訂準則與評審模型。
- 04保留評測證據將執行結果存入資料夾,並匯出 JSON 或 CSV。
使用者
用一句實用的話說明本機優先為何重要。
本機優先讓你掌控資料與工具,隱私不必依賴他人的伺服器。
本機優先軟體讓工作保持私密、可離線使用,並完全由你掌控。
評分準則有幫助準確清晰優勝:Claude Sonnet · 9.4
專注的一站式工作區
從「這個 API 能用嗎?」到「該上線哪個模型?」所需的一切。
01
並行比較多個模型
將同一份固定提示同時送到多個供應商,並排檢視每個回應與效能指標。
02
使用 LLM 評審評分
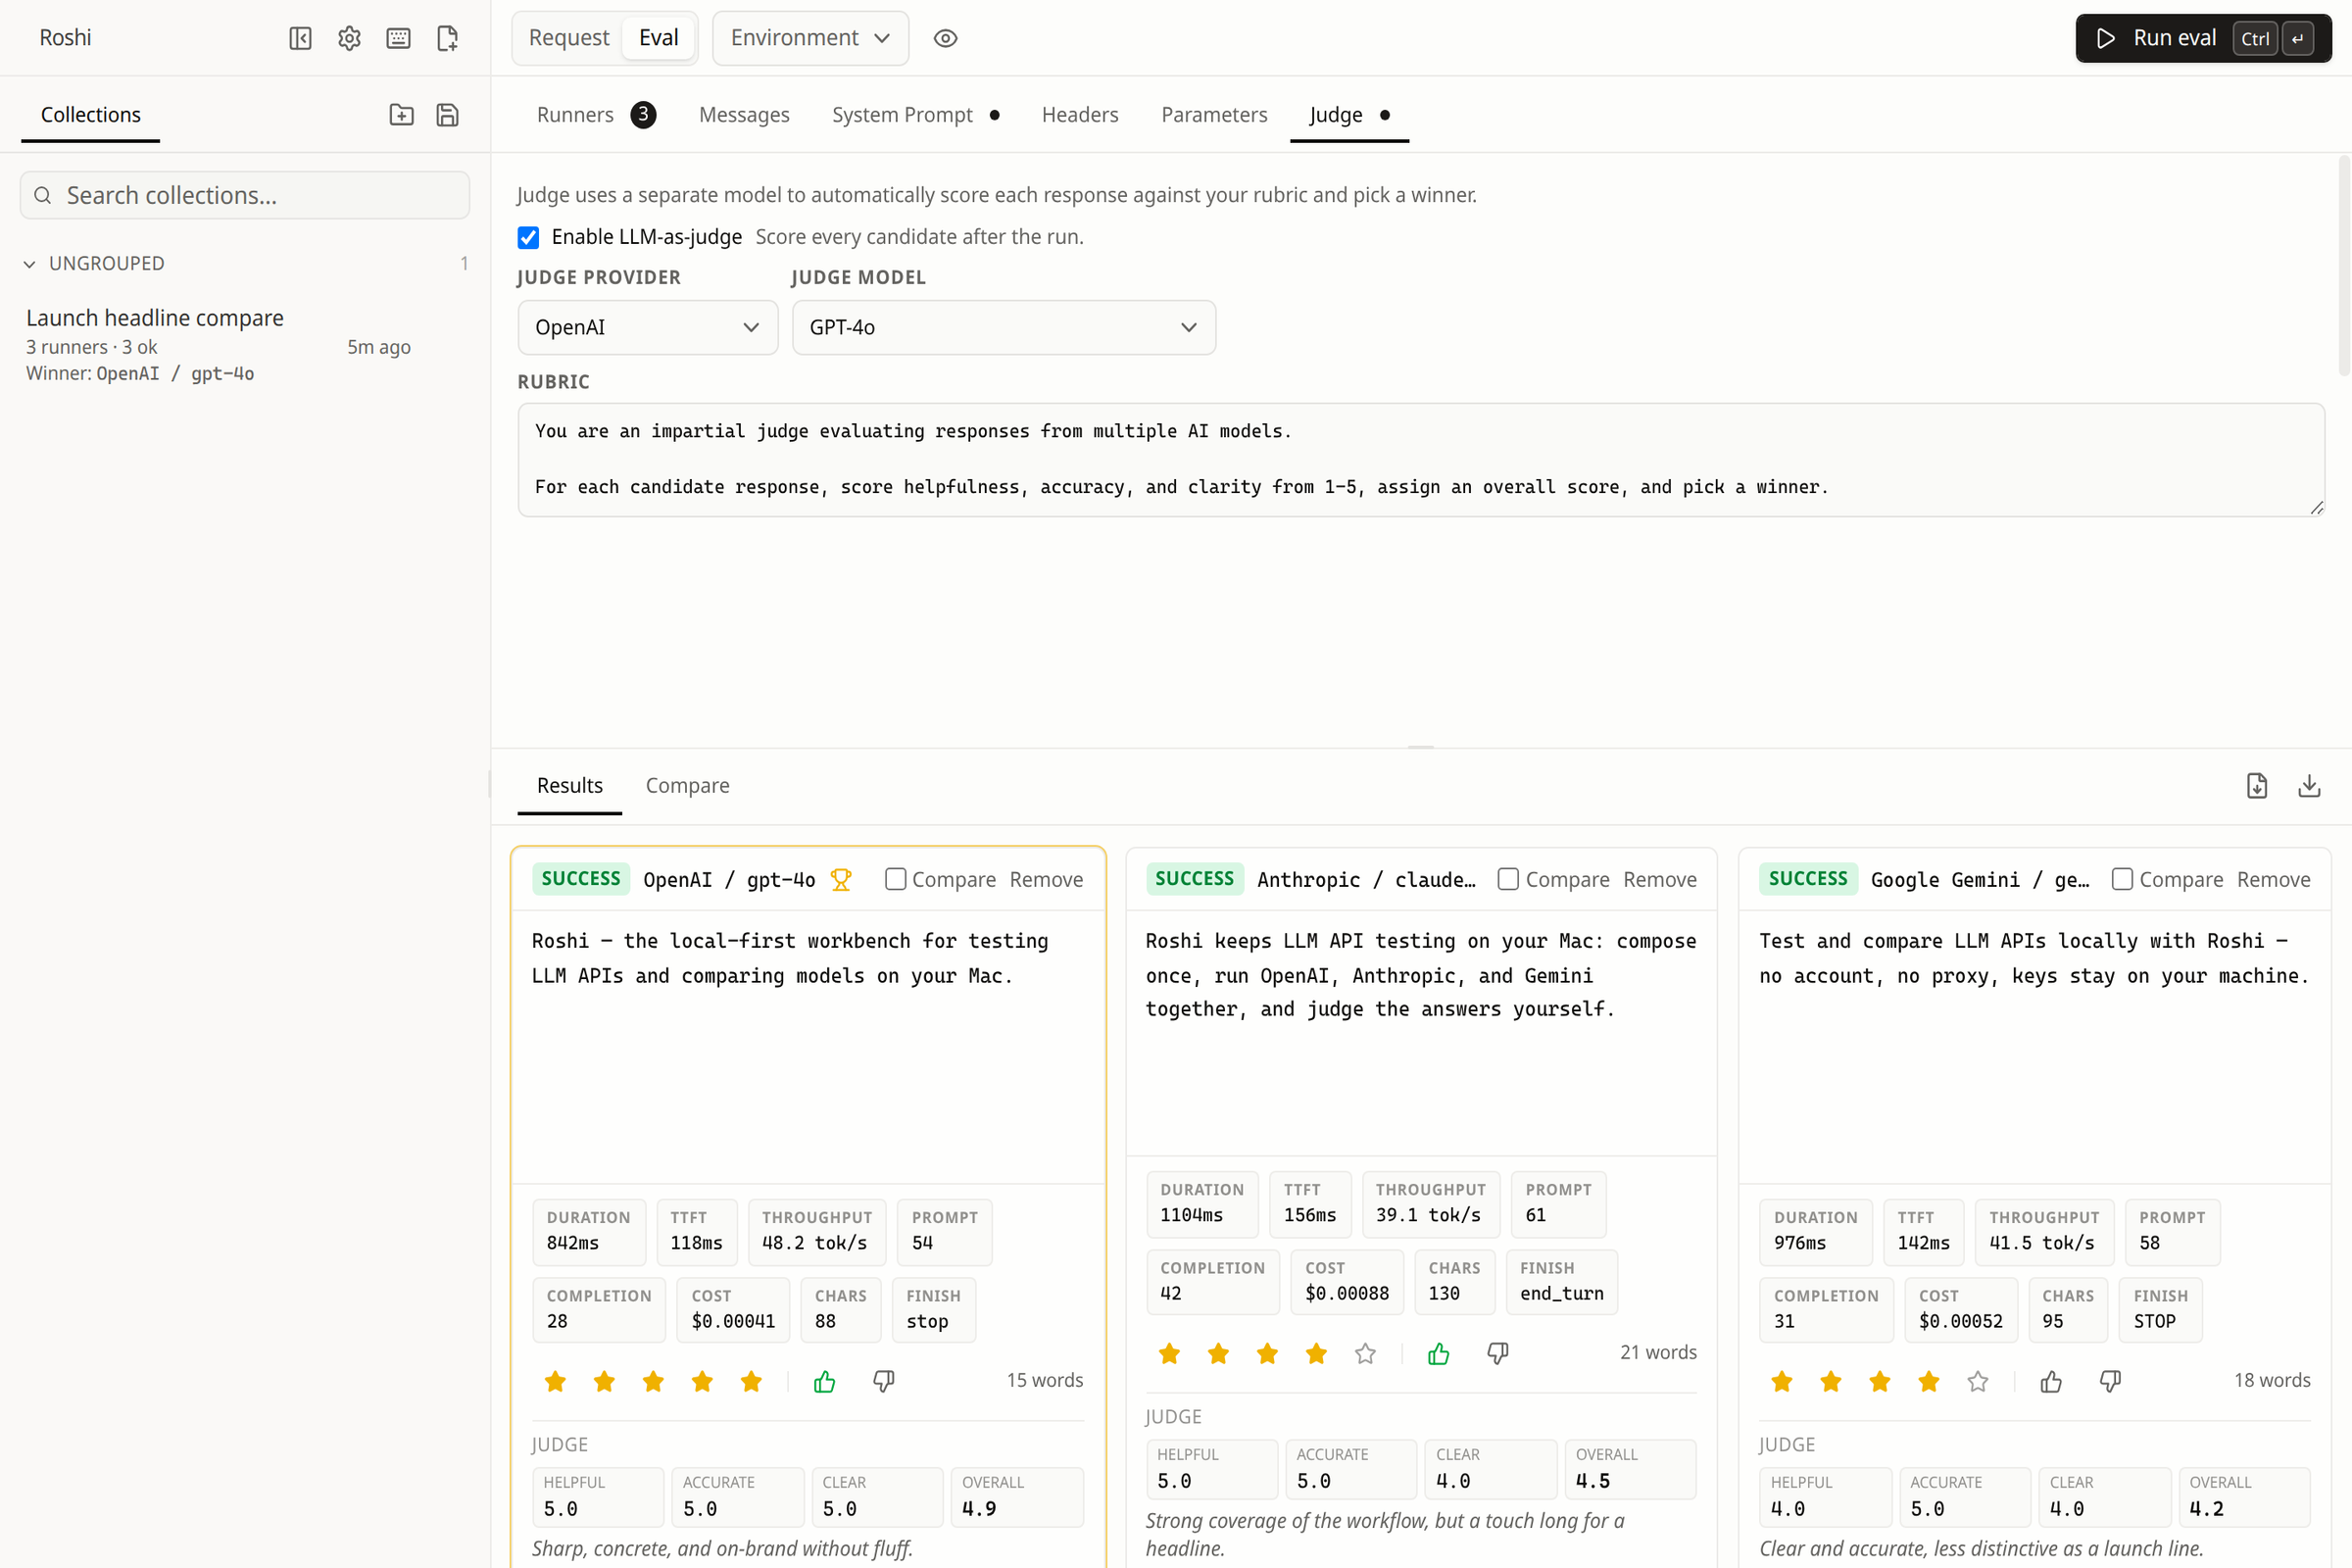
選擇評審模型並撰寫評分準則,把「哪個答案比較好」變成可重複的分數。
03
連接各種供應商
支援 OpenAI、Anthropic、Gemini、OpenRouter,以及相容上述通訊協定的自訂端點。
04
完整檢視回應
一次查看串流文字、原始回應、標頭、延遲、Token 用量,以及可直接使用的程式碼。
05
依自己的方式整理
使用收藏、環境變數、歷史記錄與已儲存的評測,介面支援英文與繁體中文。Roshi 會跟隨系統語言,也可在「設定」中切換。
06
資料留在本機
不需要 Roshi 帳號,也沒有代送請求的伺服器。金鑰、設定、請求與結果都留在你的 Mac。
Roshi 內部
從請求到決策,一條完整流程。
不必在 Playground 與腳本之間來回拼湊,就能編寫、評測並做出選擇。
01
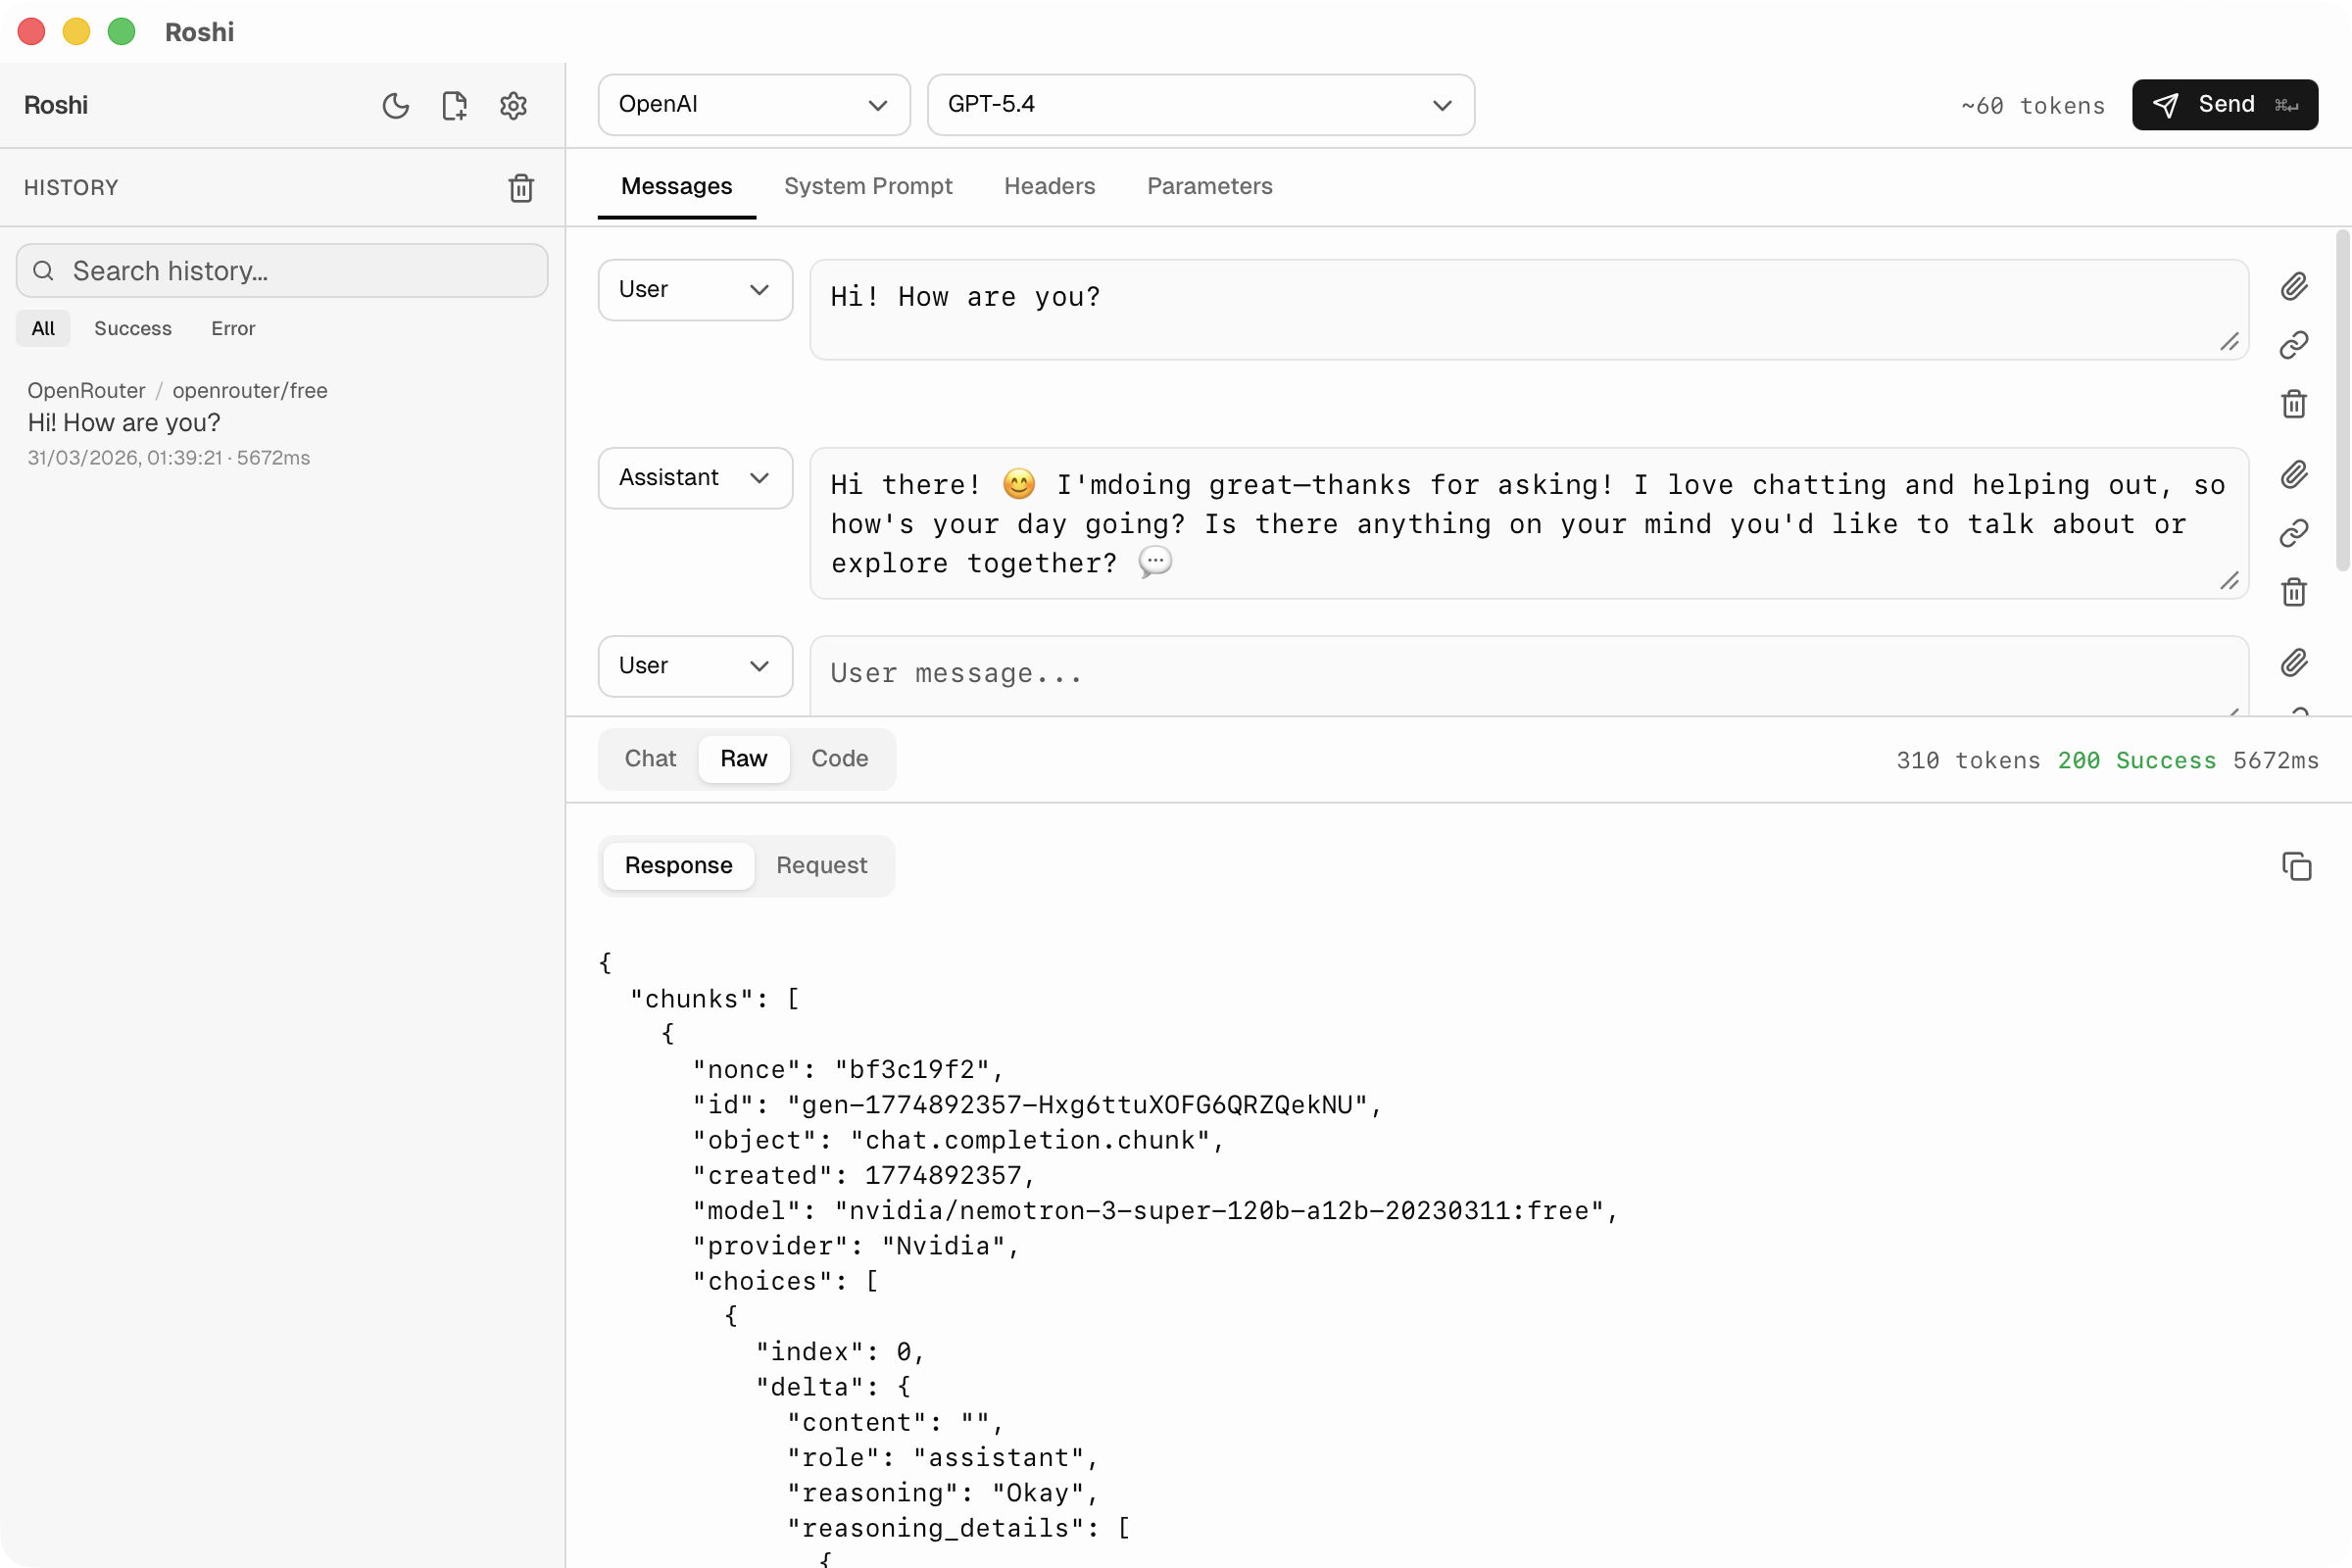
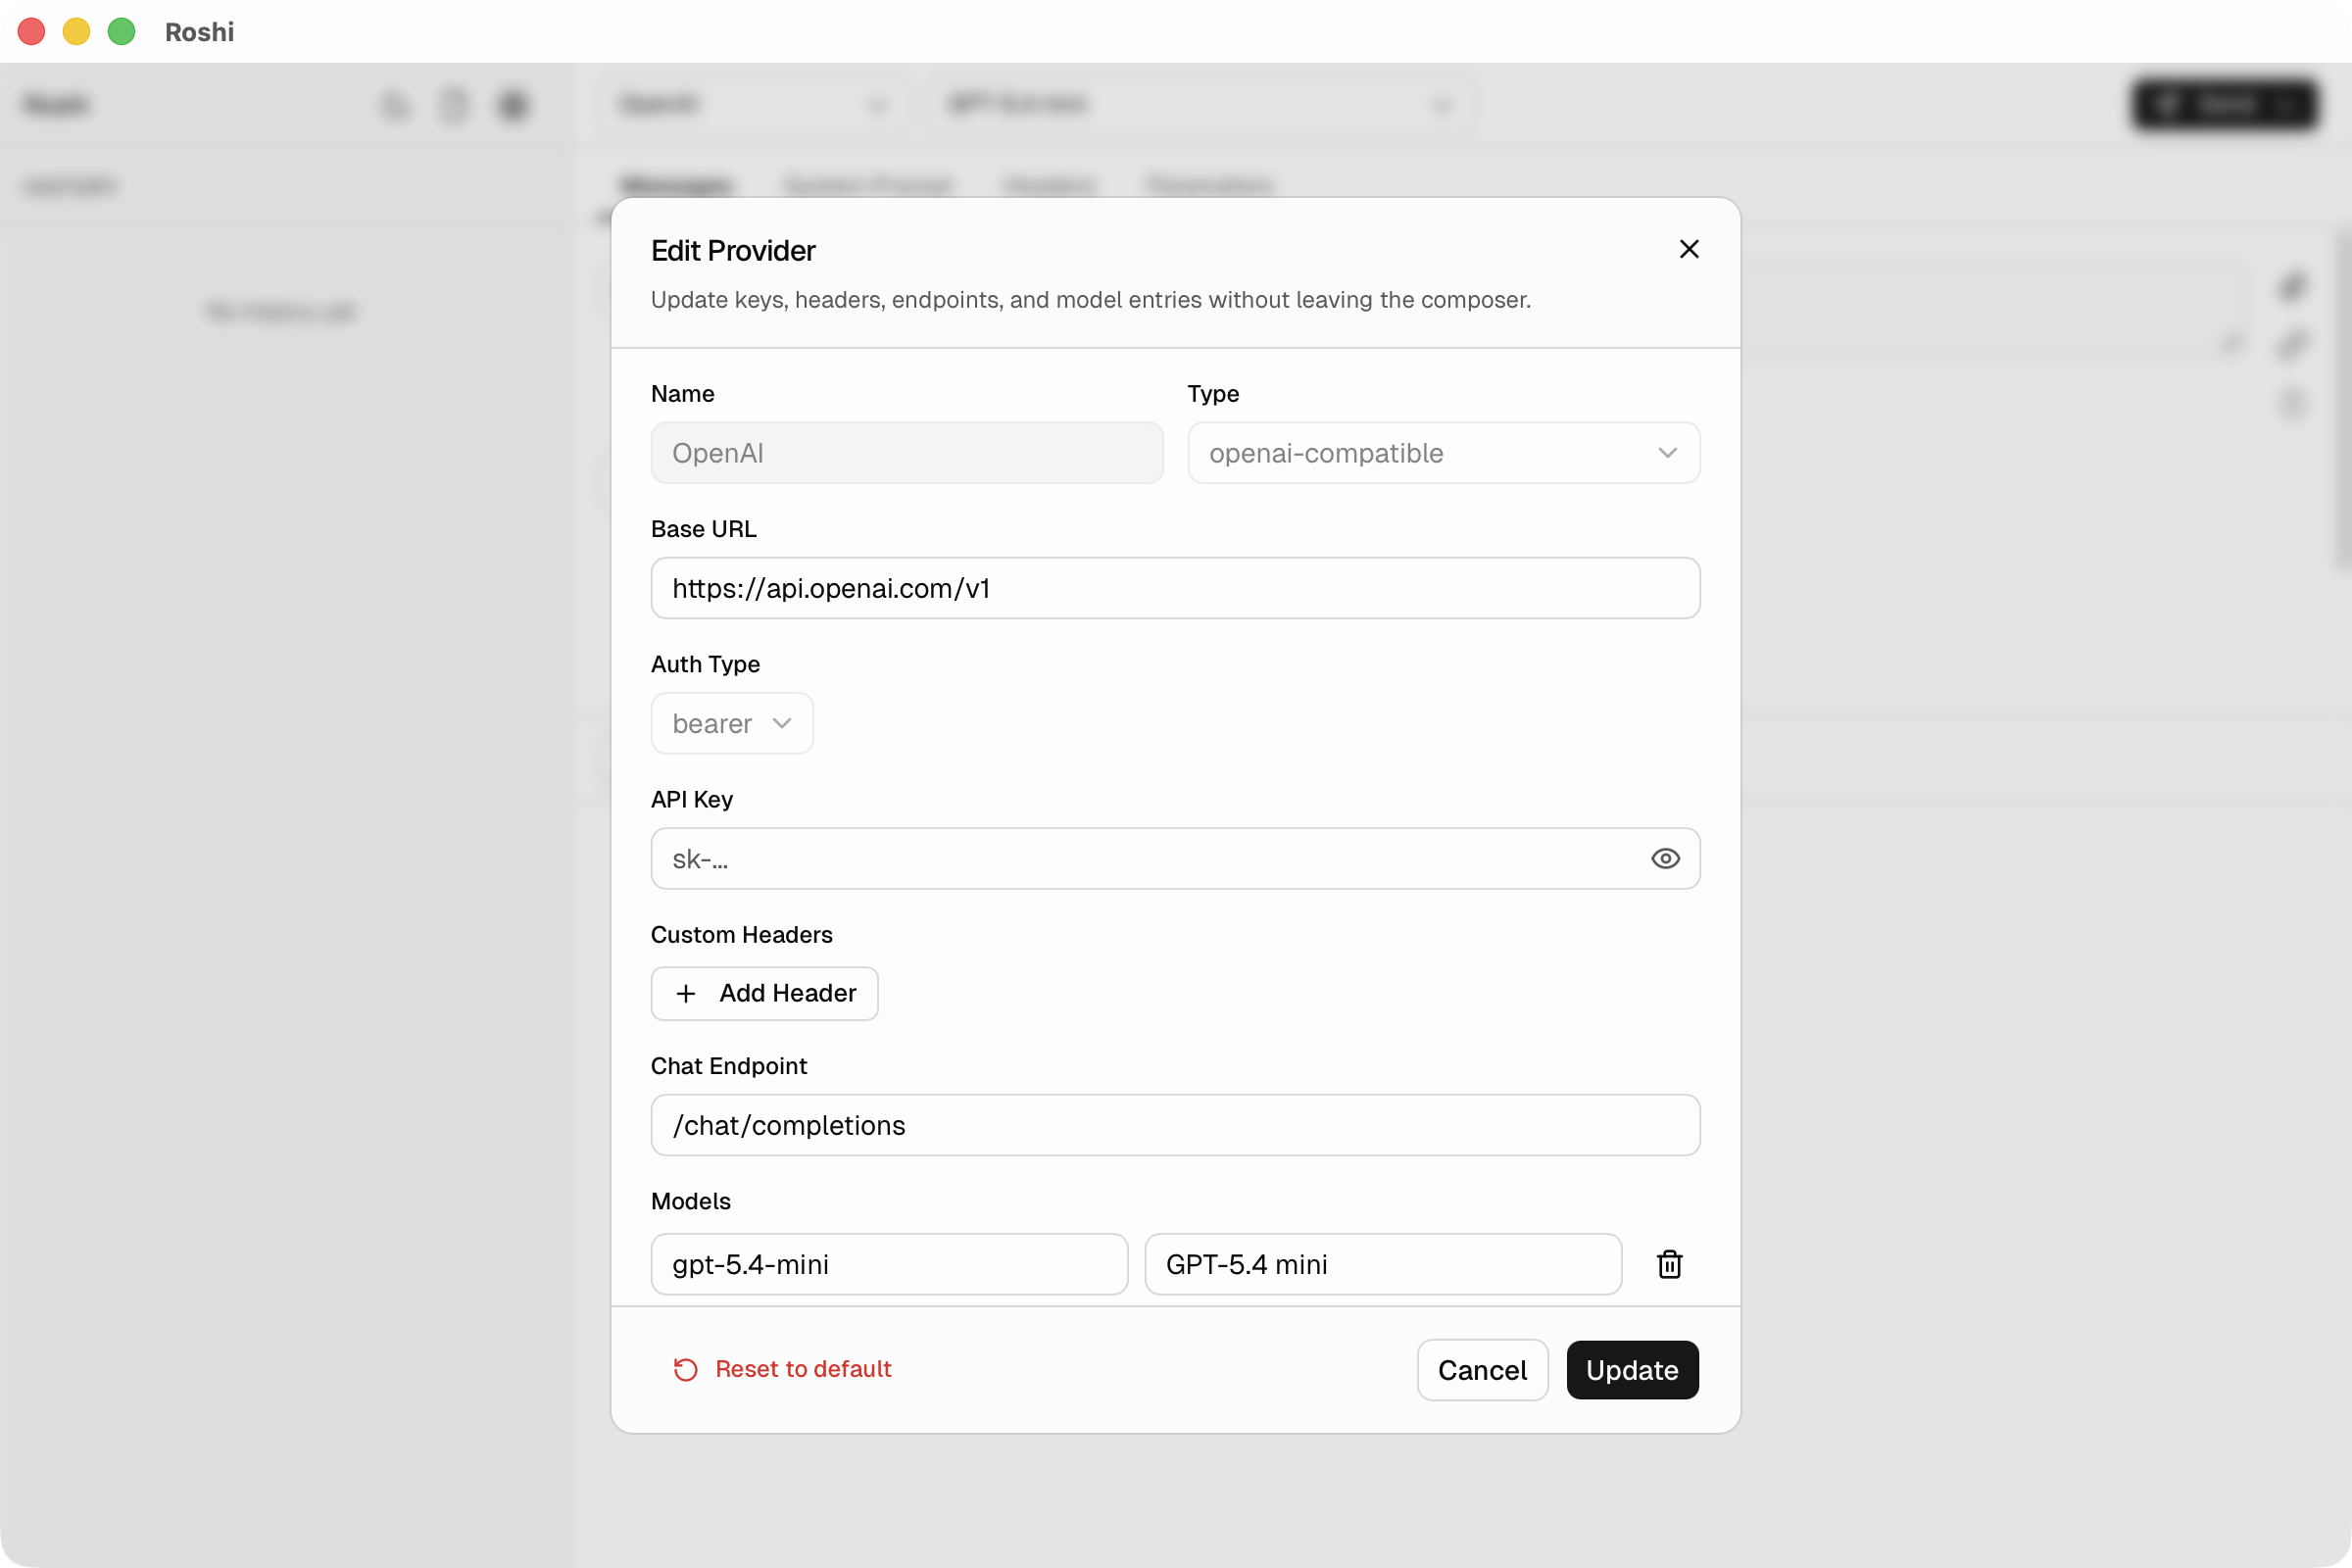
編寫與檢視
建立你真正想測試的請求。
在專注的用戶端中處理多輪訊息、系統提示詞、參數、標頭與相容端點。串流顯示答案,再直接檢視原始回應,不必切換工具。
02
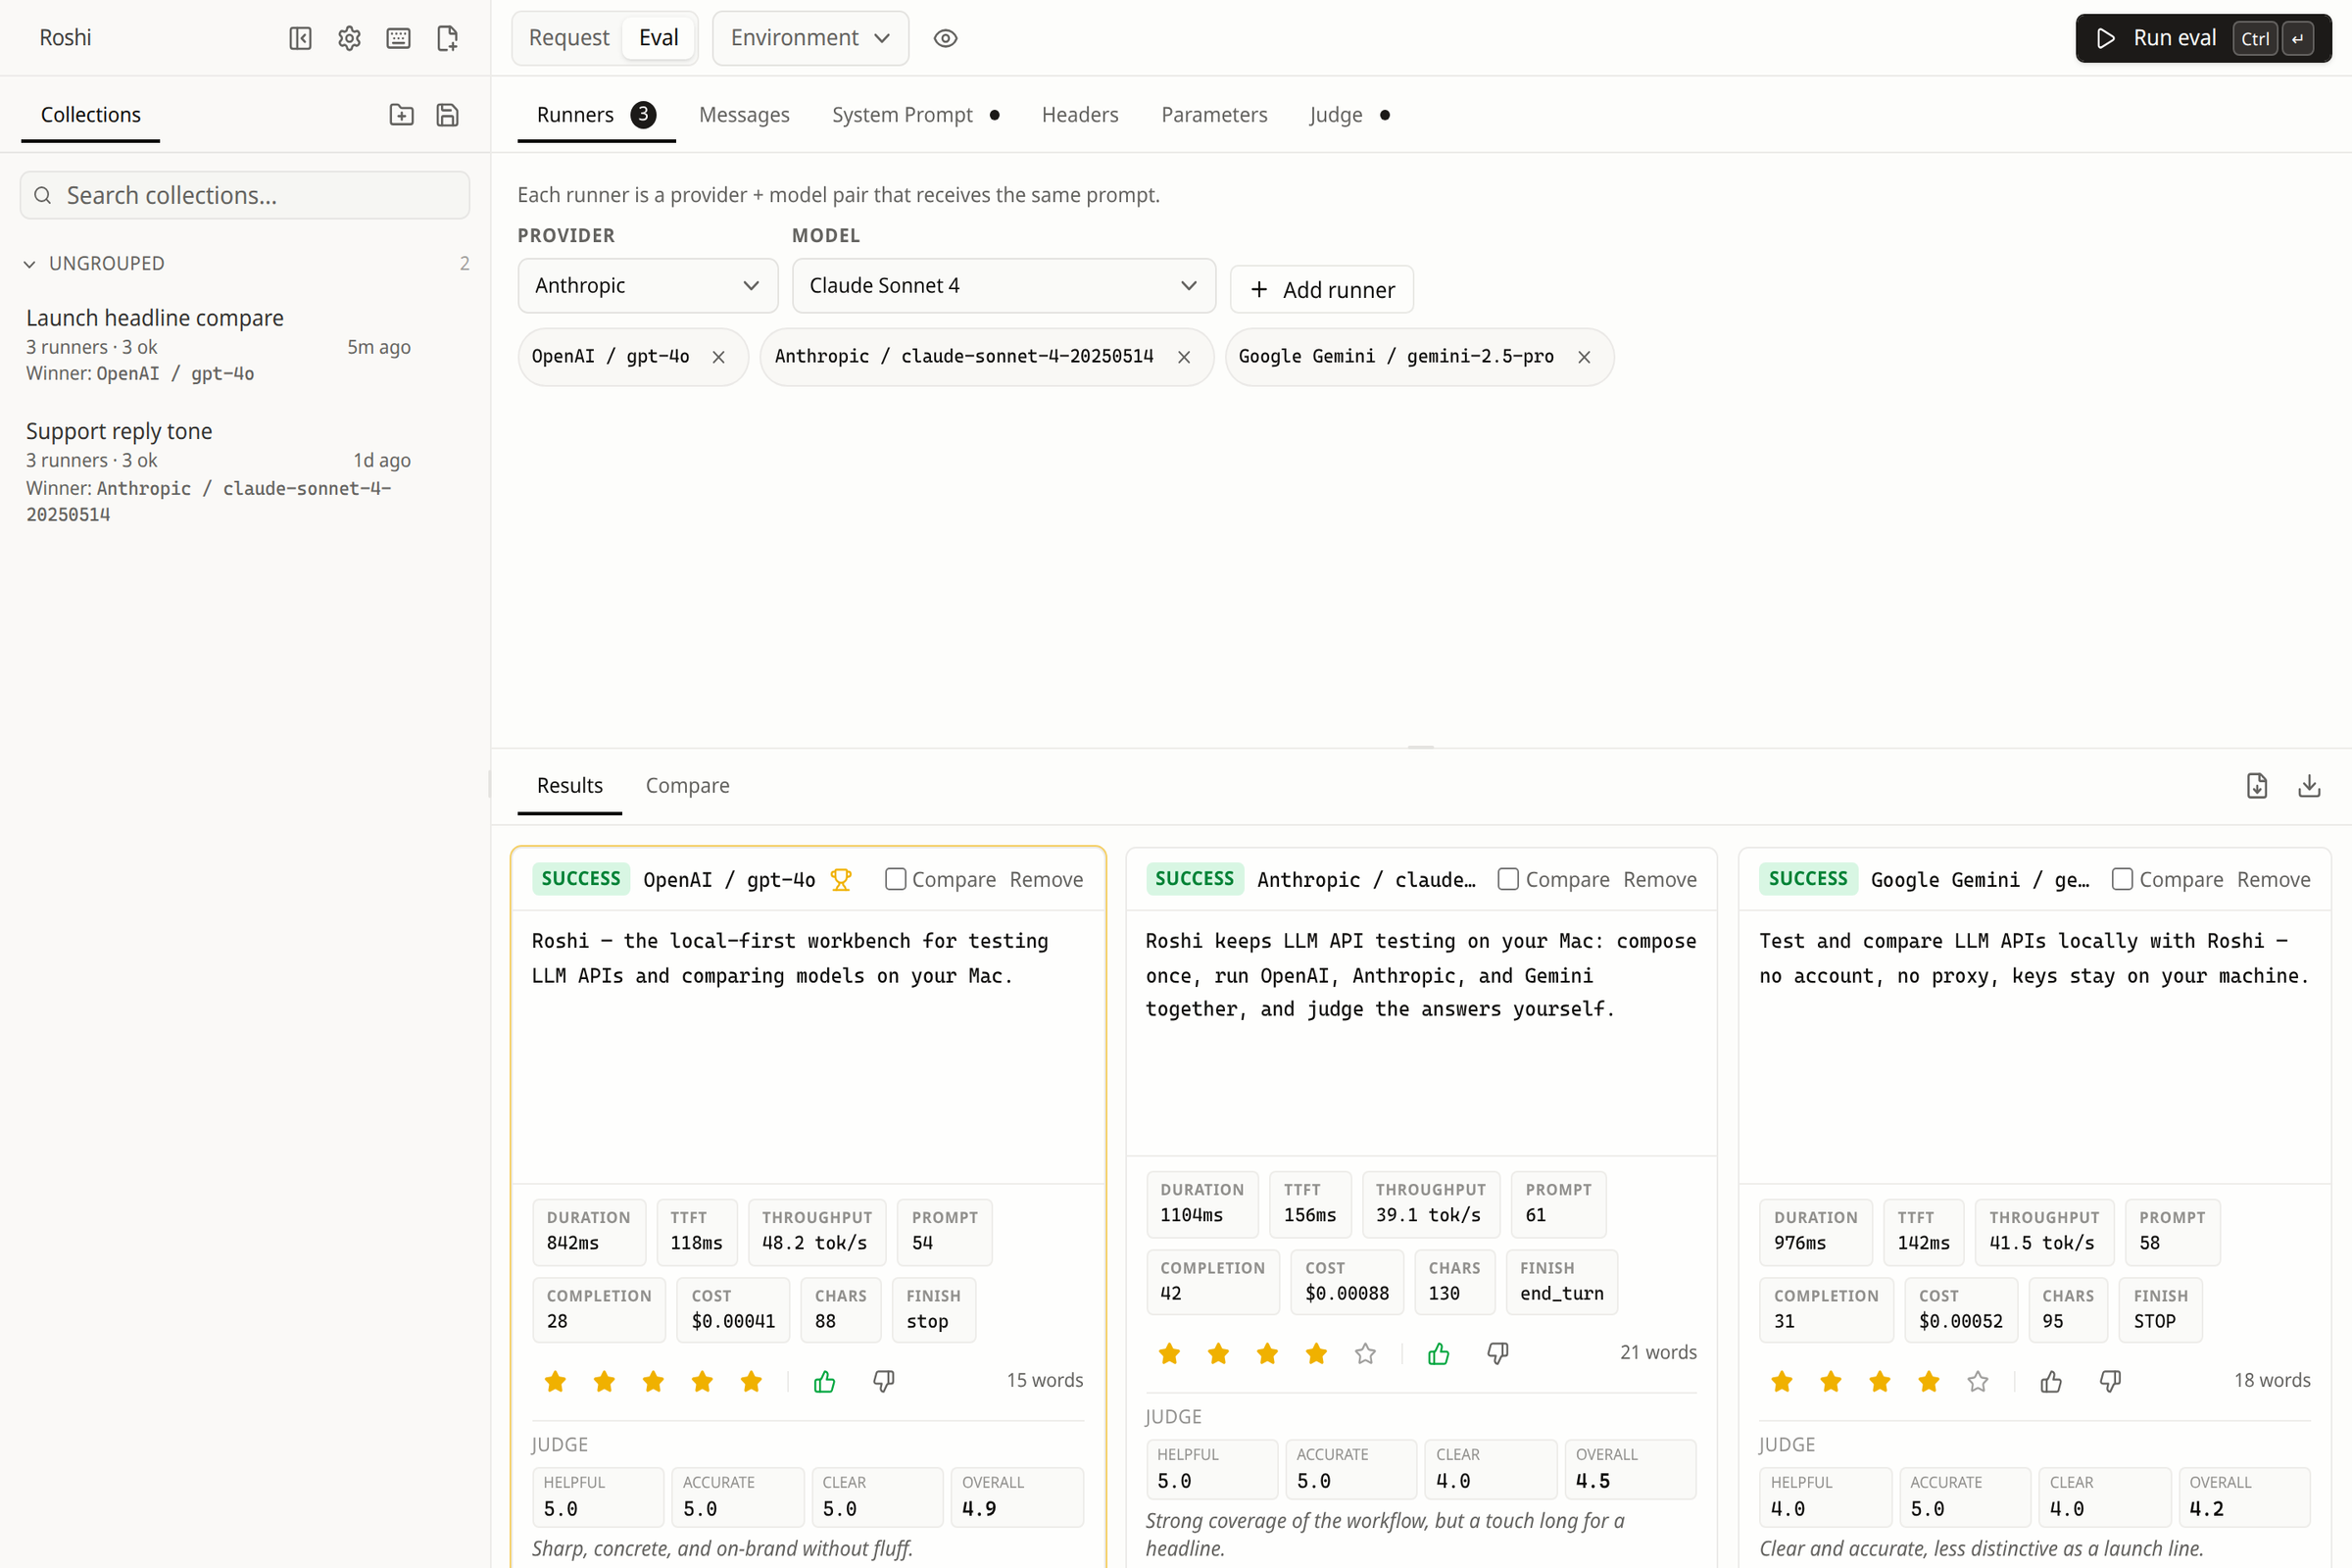
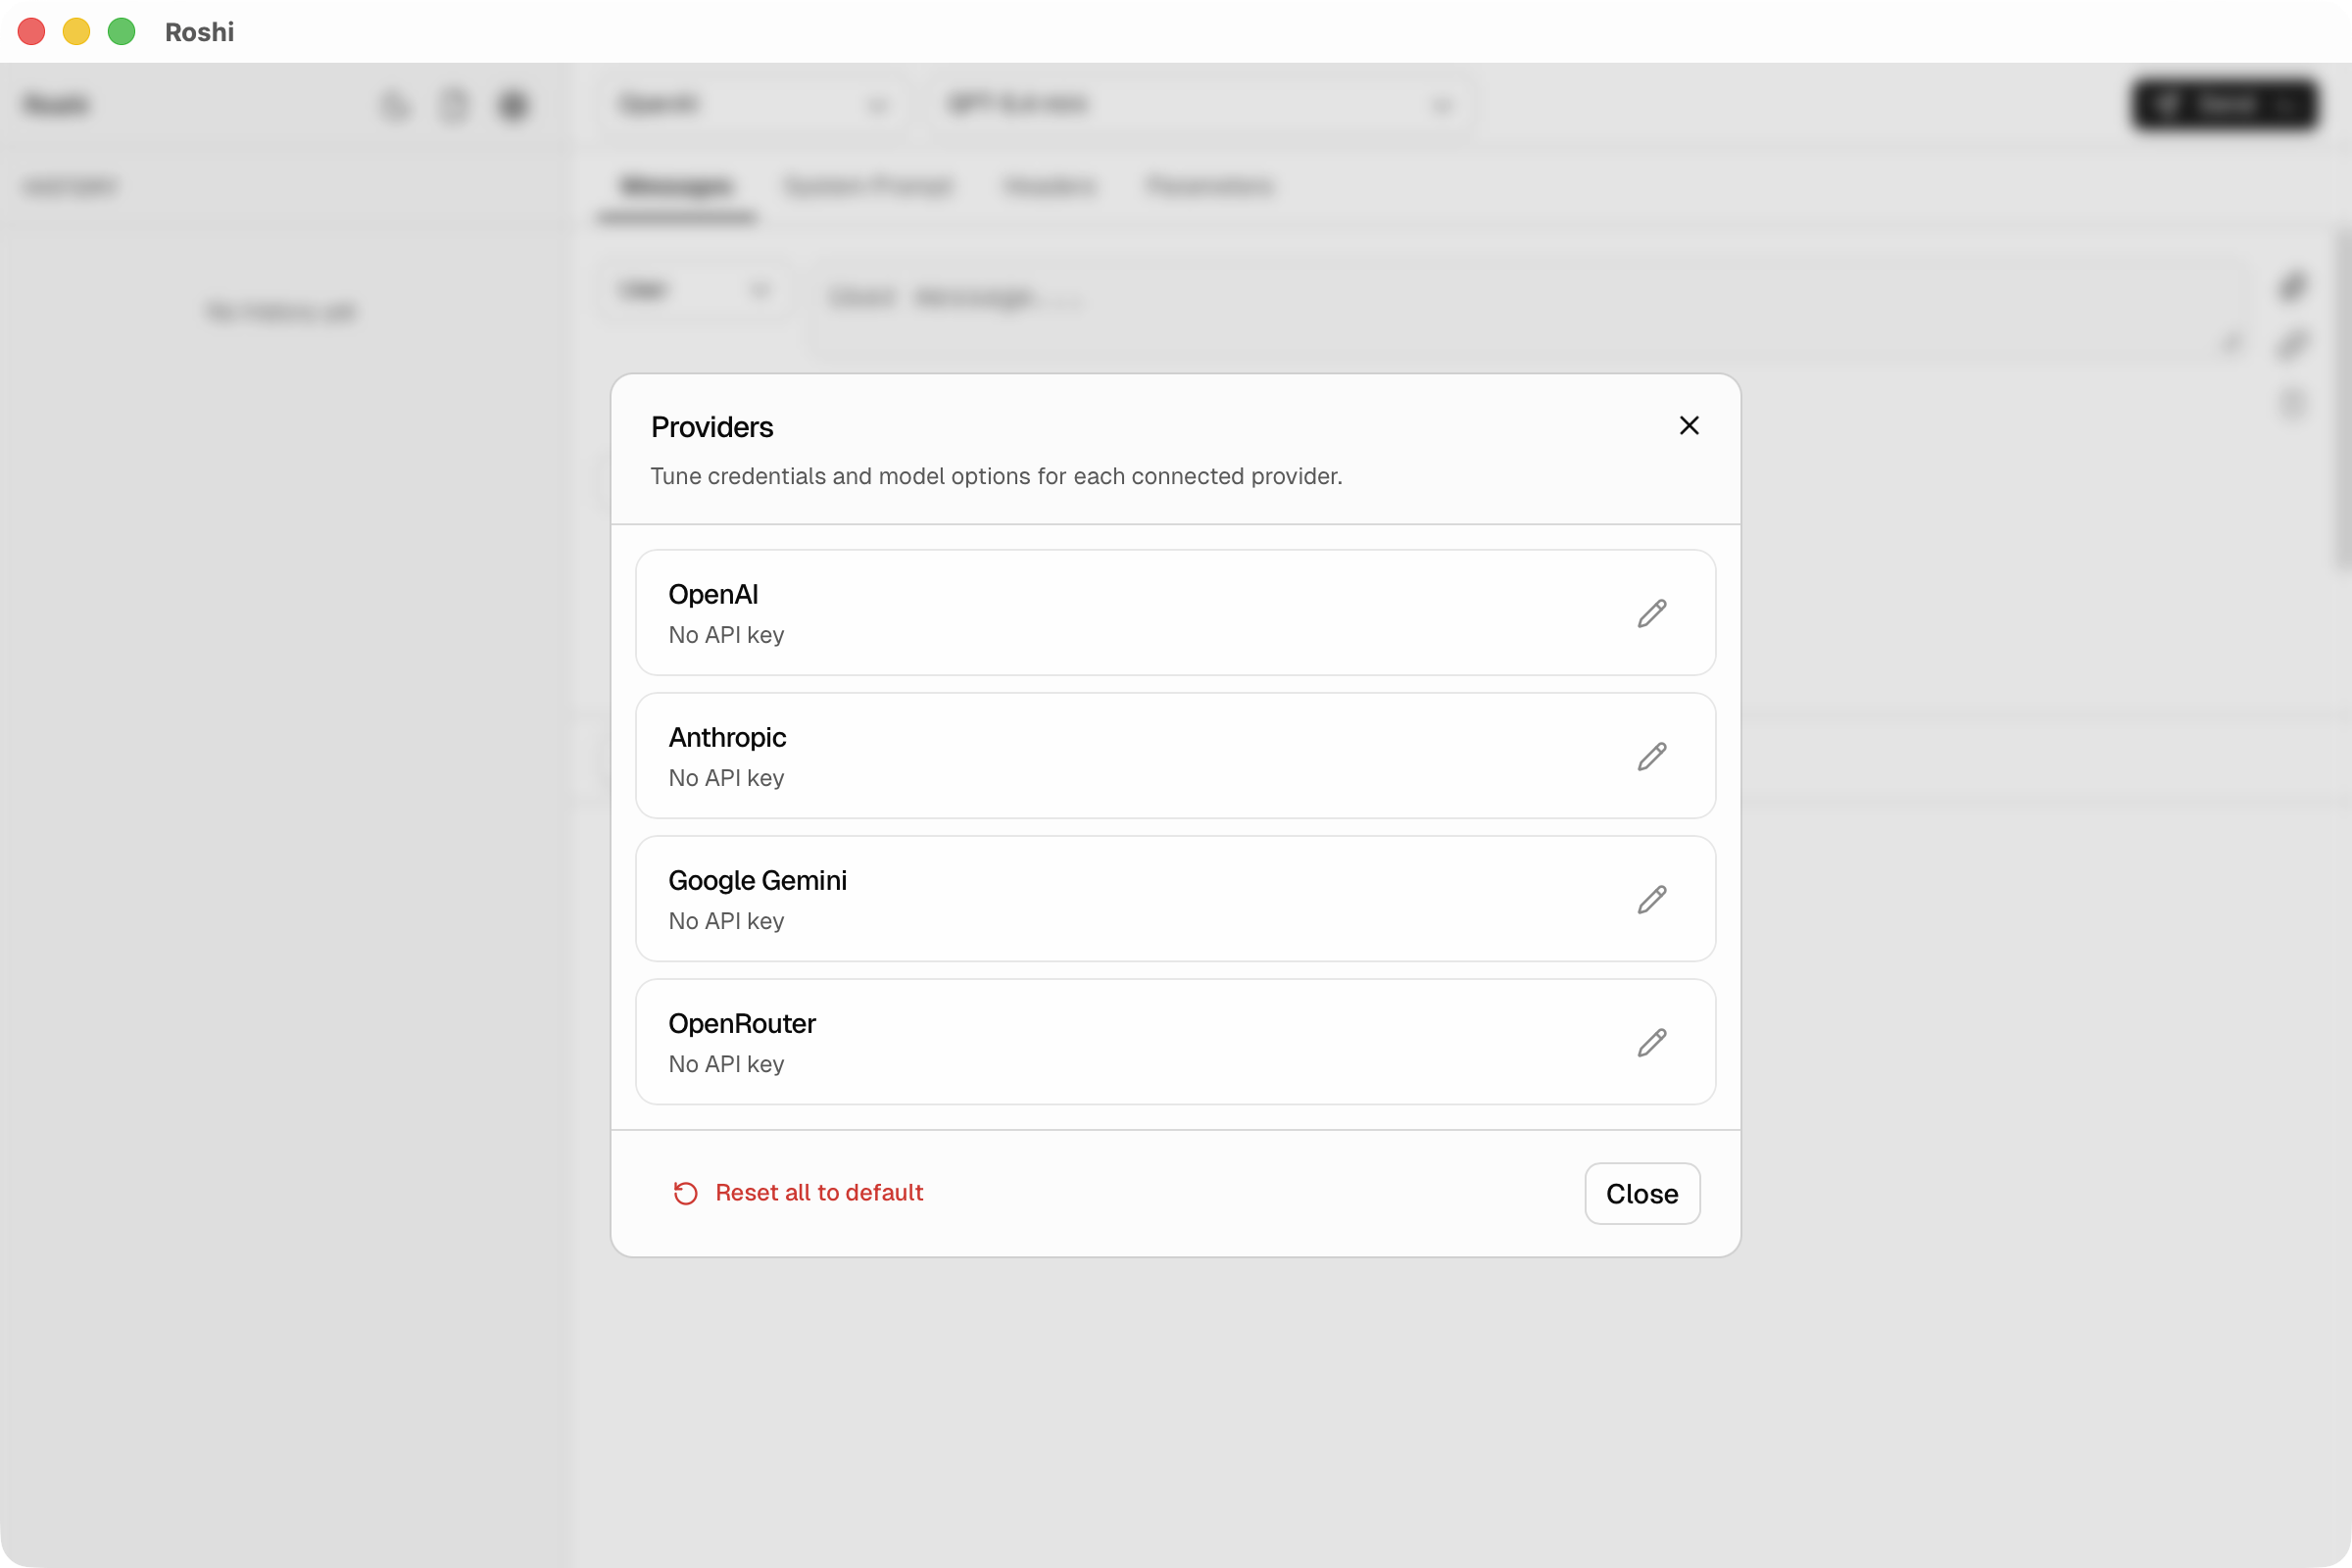
一起執行
讓每個模型站在同一起跑線。
選擇你已在使用的供應商,將同一份固定請求並行送到多個模型。Roshi 會對齊輸出、延遲、Token 與成本,確保比較公平。
03
用證據決策
把不同答案變成可辯護的選擇。
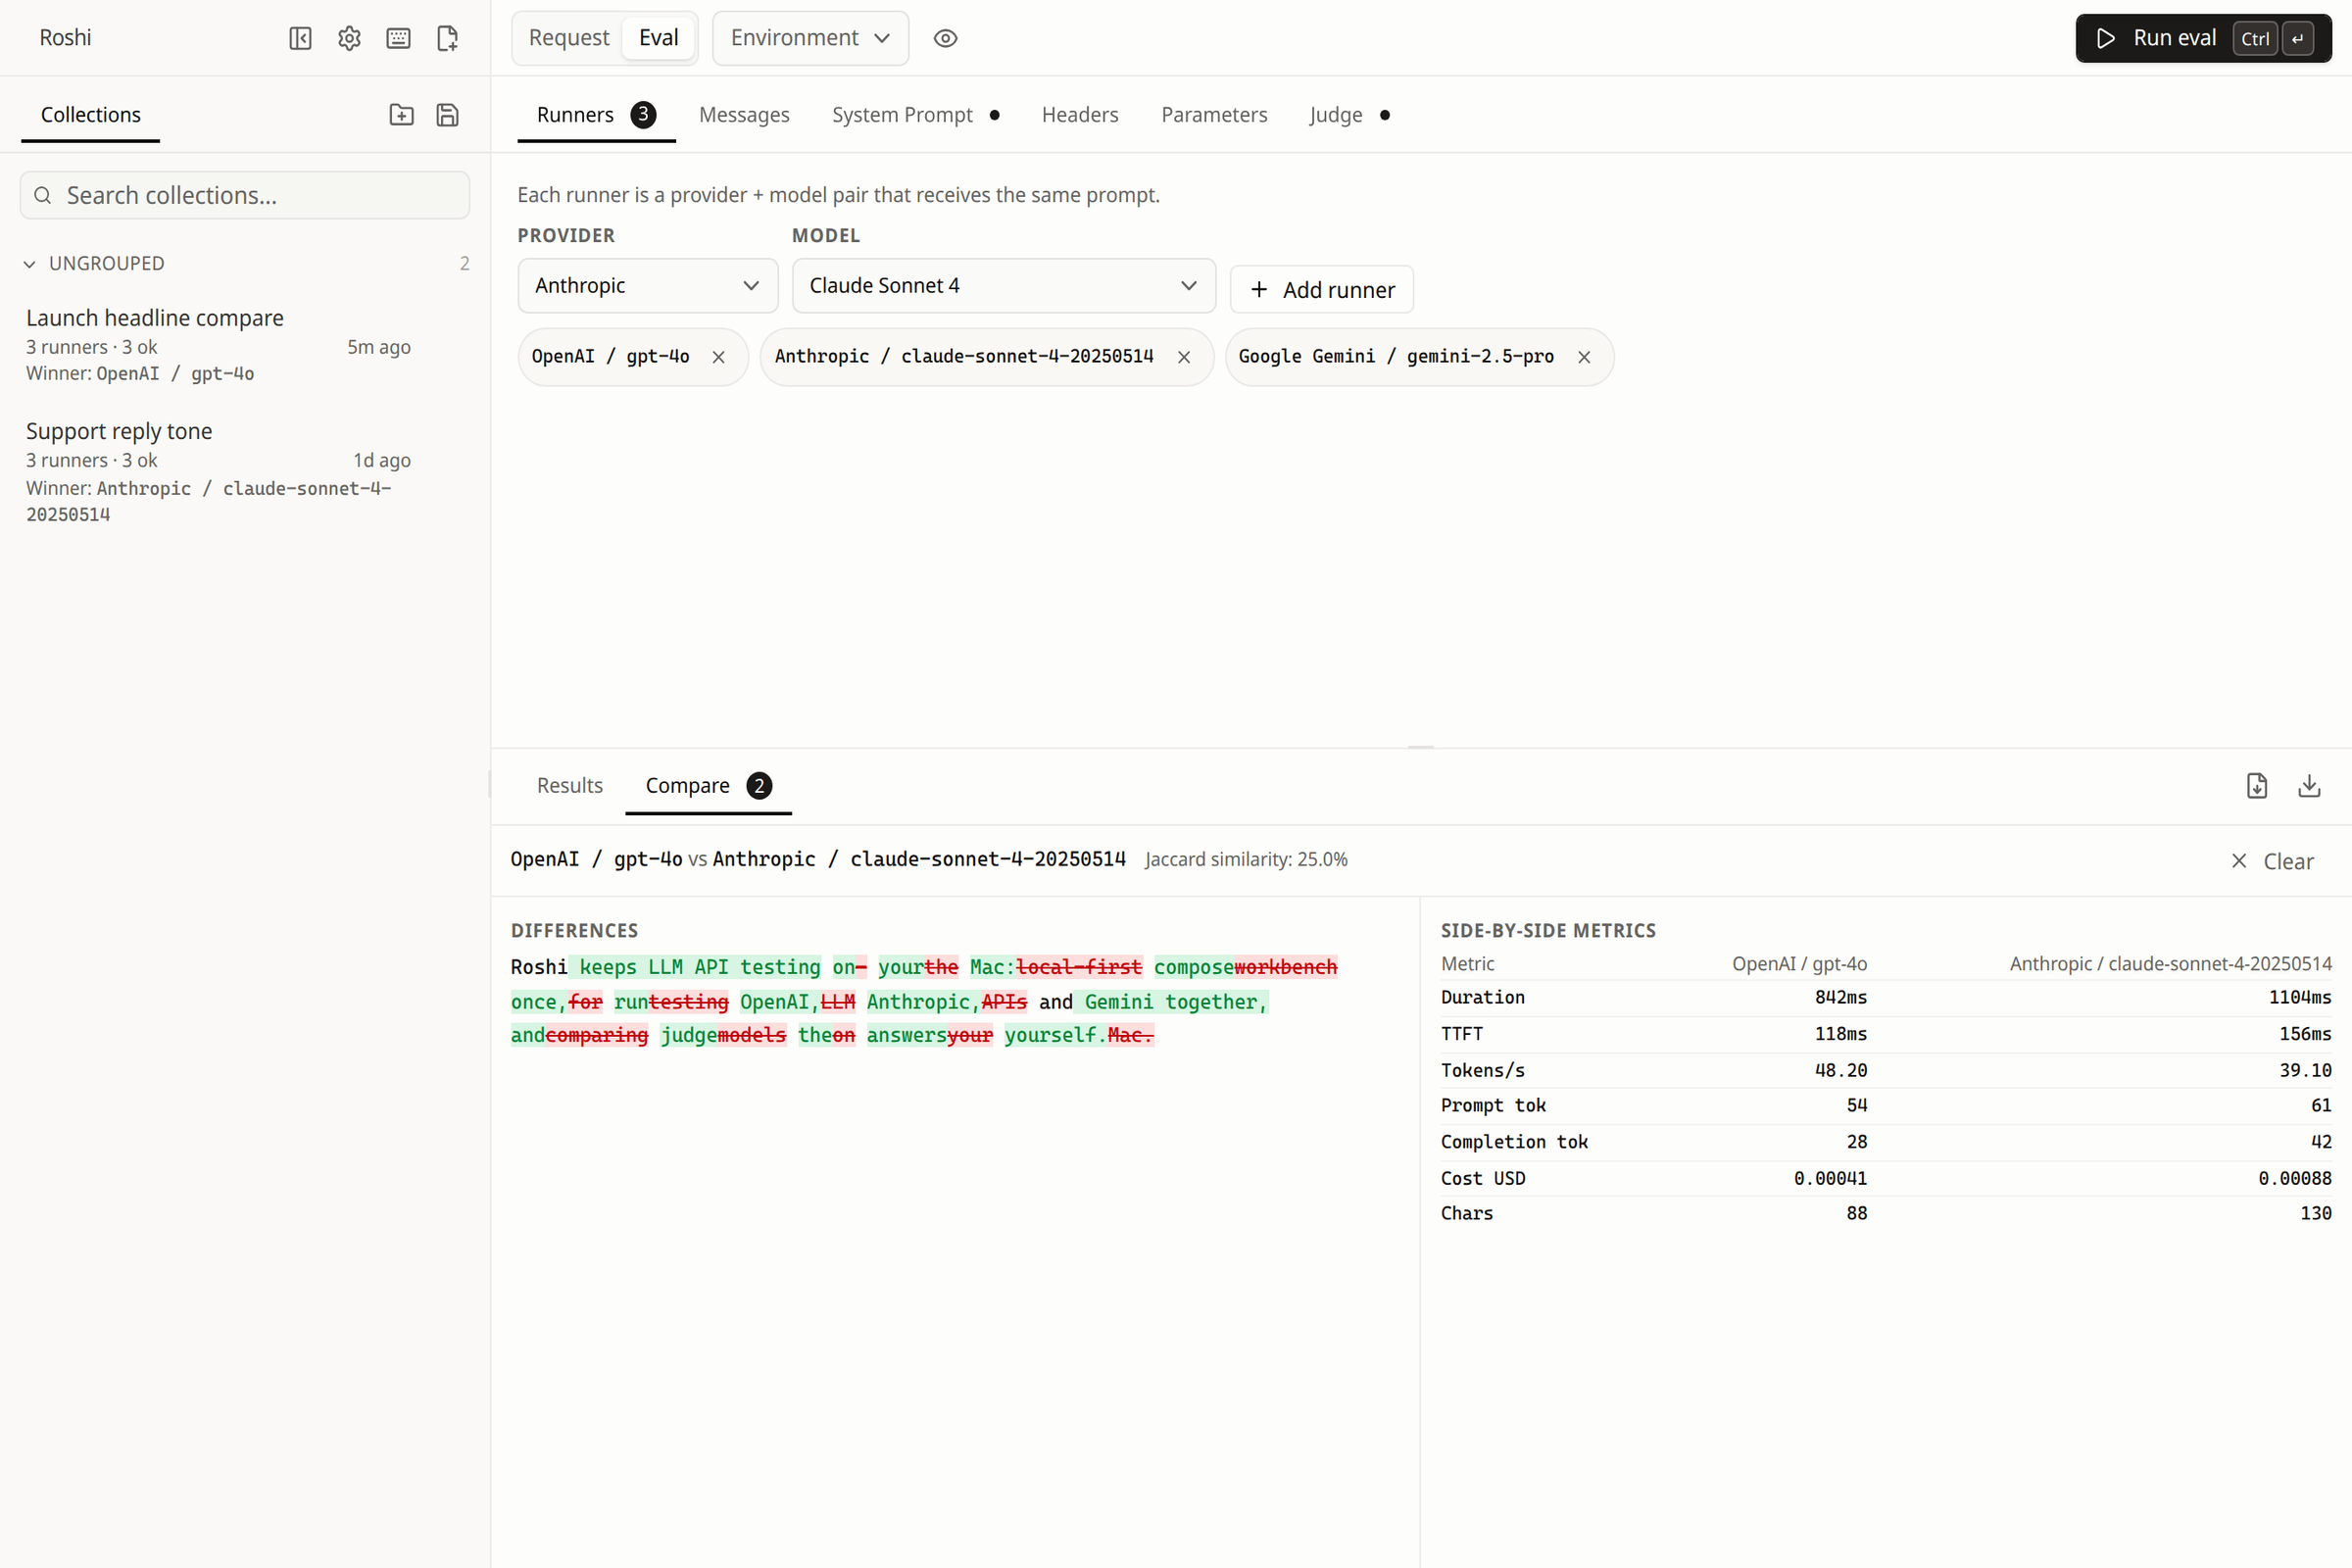
逐字比較任意兩個回應、檢視效能指標,再手動評分,或使用另一個模型與自訂準則擔任評審。
使用流程
從 API 金鑰到可上線的模型。
加入供應商
將 API 金鑰貼到內建範本,或設定自己的端點、標頭與模型清單。
編寫與除錯
編輯訊息、圖片、參數與標頭,同時觀察串流回應、原始內容與耗時。
比較模型
將同一個請求送到多個模型,比較輸出與指標,再手動評分或執行 LLM 評審。
儲存並交付
儲存評測、匯出 JSON 或 CSV,並從驗證完成的請求產生可用的程式碼。
安全性
你的金鑰永遠不會離開電腦。
Roshi 完全在用戶端執行。沒有帳號、沒有託管代理,供應商流量也不會經過我們的服務。請求會從你的 Mac 直接送到供應商,金鑰則保存在本機資料庫。詳細資訊請參閱 安全性設計文件(英文)。
你可以自行驗證
- 公證透過 CI 交由 Apple 公證
- 沙盒App Store 版本在沙盒中執行
- 更新App Store 自動 · GitHub 手動
- 金鑰儲存只保存在你的 Mac
- 遙測應用程式內完全沒有
- 授權MIT,v2.4.0
下載
無論哪種版本,功能都完整開放。
兩個版本來自相同的 MIT 授權原始碼,唯一差別是更新方式。
直接下載
免費
直接從 GitHub Releases 下載已簽署及公證的 .dmg。
- 所有功能,沒有用量限制
- 支援 Apple 晶片與 Intel
- 在 App Sandbox 之外執行
- 手動更新 — 自行下載新版本
- 也可以從原始碼建置
Mac App Store
US$0.99單次購買
相同的應用程式,由 Apple 安裝並保持最新。
- 包含直接下載版的所有功能
- 透過 App Store 自動更新
- 在 Apple App Sandbox 中執行
- 可安裝在 Apple 帳號綁定的每台 Mac
- 支援 Roshi 持續開發
常見問題
你可能想知道的事。
Roshi 是什麼?
Roshi 是為呼叫 LLM API 的開發者打造的本機優先 macOS 應用程式。你可以編寫多輪對話請求、串流回應、檢視標頭與 Token,並以相同提示比較及評分多個模型。
Roshi 會透過後端伺服器轉送請求嗎?
不會。Roshi 完全在用戶端執行,你的 Mac 會直接連線到模型供應商,金鑰也只儲存在本機。
支援哪些模型供應商?
內建支援 OpenAI、Anthropic、Google Gemini 與 OpenRouter,也能加入任何相容 OpenAI、Anthropic 或 Gemini 通訊協定的端點。
Roshi 支援哪些介面語言?
Roshi 支援英文與繁體中文。介面預設跟隨系統語言,也可以隨時在「設定」中切換。
模型評測如何運作?
從已確認可用的請求開始,選擇多個供應商與模型並行執行。你可以並排比較輸出及效能指標、手動評分,或讓另一個模型依照自訂準則擔任評審。
API 金鑰與評測結果存在哪裡?
供應商設定、API 金鑰、請求歷史、草稿、收藏、環境變數與評測結果都儲存在你的 Mac。Roshi 沒有帳號系統或託管後端。
免費下載版和 Mac App Store 版有何不同?
兩者都來自相同的 MIT 授權原始碼,功能完全相同。免費 GitHub 版需手動更新;Mac App Store 版售價 US$0.99,可自動更新並支援後續開發。
系統需求是什麼?
Roshi 支援 macOS 12 Monterey 或更新版本,Apple 晶片與 Intel Mac 都能使用。
Roshi 是開放原始碼嗎?
是。Roshi 採用 MIT 授權,你可以自由使用、修改與散布。